
Der Begriff „Model Routing“ fällt in fast jedem LLM-Projekt, das wir in den letzten Monaten bei Kunden gesehen haben, nur meint jedes Team etwas anderes damit. Das eine schickt einfache Anfragen per Klassifikator an ein kleines Modell, um Kosten zu sparen. Das nächste hat einen Proxy, der bei einem HTTP 429 auf einen zweiten Anbieter ausweicht. Das dritte betreibt ein Gateway, das Prompts mit Kundendaten gar nicht erst zu einem externen Anbieter durchlässt. Alle drei sagen „wir routen“ und reden im gemeinsamen Workshop aneinander vorbei.
Wir wollten das für uns sortieren. Kunden fragen uns, welcher Ansatz zu ihnen passt, und darauf wollen wir eine bessere Antwort geben als „kommt drauf an“. Außerdem routen wir selbst: in der Trade Fair Data Platform, die über 650 Messen mit zwei KI-Agents aktuell hält, und im Finanzumfeld, wo wir mit Gravitee arbeiten. Beim Sortieren haben wir gemerkt, dass wir eine dieser Entscheidungen im eigenen Projekt lange nach dem falschen Kriterium getroffen haben.
Drei Fragen, ein Begriff
Die Router, die wir in Kundenprojekten gesehen haben, beantworten jeweils eine von drei Fragen:
- Darf die Anfrage dorthin? Hier geht es um Governance: Welche Daten stecken im Prompt, welche Modelle sind dafür freigegeben, und hat das Team sein Budget schon aufgebraucht?
- Welches Modell? Hier wird Qualität gegen Kosten abgewogen: Reicht ein kleines Modell, oder braucht die Aufgabe das große?
- Welcher Anbieter? Hier geht es um Verfügbarkeit. Viele Modelle gibt es bei mehreren Anbietern oder in mehreren Regionen, und nicht jeder antwortet zu jeder Zeit zuverlässig und schnell genug.
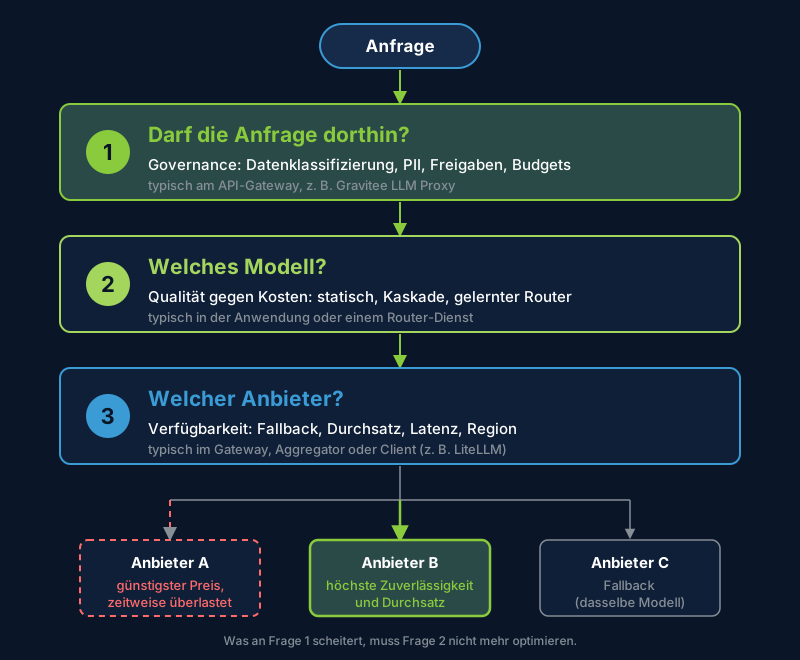
In dieser Reihenfolge durchläuft eine Anfrage die Entscheidungen. Was an der ersten Frage scheitert, braucht keine Modellwahl mehr, und die klügste Modellwahl nützt nichts, wenn der Anbieter gerade mit 503 antwortet.
Auf Konferenzen und in Kundengesprächen dreht sich fast alles um die zweite Frage. Nach unserer Erfahrung entscheiden die erste und die dritte öfter darüber, ob ein System im Betrieb funktioniert.
Wer Modelle selbst betreibt, hat noch eine vierte Frage: Welche Replica auf welcher GPU bekommt die Anfrage? Darum kümmern sich im Kubernetes-Umfeld Projekte wie llm-d und die Gateway API Inference Extension. Das ist ein eigenes Thema und bleibt hier außen vor.
Die Ansätze im Überblick
Zur Orientierung vorab die Ansätze, die uns in Projekten begegnet sind. Die folgenden Abschnitte gehen sie in dieser Reihenfolge durch.
| Ansatz | Beantwortet | Wo es sitzt | Sinnvoll für |
|---|---|---|---|
| Policy-Routing | Darf die Anfrage dorthin? | API-Gateway, z. B. Gravitee | regulierte Umgebungen, mehrere Teams |
| Statisch pro Aufgabe | Welches Modell? | Konfiguration der Anwendung | Pipelines mit bekannten Schritten |
| Kaskade | Welches Modell? | Anwendung | Aufgaben mit prüfbarem Ergebnis |
| Klassifikator / gelernter Router | Welches Modell? | Router-Dienst, z. B. vLLM Semantic Router, RouteLLM, Bedrock Intelligent Prompt Routing | offene Eingaben mit viel Volumen |
| Anbieter-Routing | Welcher Anbieter? | Gateway, Aggregator oder Client-Bibliothek wie LiteLLM | jedes System in Produktion |
Darf die Anfrage dorthin: Routing als Governance
Im Finanzumfeld arbeiten wir mit Gravitee, und dort hat Routing mit Kostenoptimierung wenig zu tun. Die Fragen lauten: Welche Anwendung darf welches Modell nutzen? Was passiert mit personenbezogenen Daten im Prompt? Wer hat wie viele Tokens verbraucht, und lässt sich das einer Kostenstelle zuordnen? Vorweg: Wir sind Gravitee-Partner, neutral ist dieser Abschnitt also nicht.
Der LLM Proxy von Gravitee setzt eine gemeinsame Eingangstür vor mehrere Anbieter. Anwendungen sprechen einen Alias an, und das Gateway entscheidet, welches Backend dahintersteht. Token-basiertes Rate Limiting, PII-Filter und Guardrails greifen, bevor eine Anfrage das Modell erreicht, und für jede Anfrage wird festgehalten, welches Modell mit wie vielen Input- und Output-Tokens geantwortet hat.
Welches Modell eine Anfrage bekommt, bestimmt dabei der Client über den Modellnamen, ein Alias oder eine Policy, die zum Beispiel einen Header auswertet. Mit Version 4.13 kommt laut Gravitee Routing nach Budget dazu: Solange das Budget eines Konsumenten reicht, gehen seine Anfragen an die besten Modelle, mit schwindendem Budget an günstigere. Eine Modellwahl nach Inhalt oder Schwierigkeit der Anfrage beschreibt die Dokumentation nicht. Wer sie braucht, setzt dafür einen eigenen Router dahinter.
Technisch ist das API-Management, angewandt auf LLM-Traffic, so wie wir es im MCP Maturity Model für Tool-Aufrufe beschrieben haben. Der Gewinn liegt in der Trennung der Zuständigkeiten: Das Fachteam entscheidet in seiner Anwendung über die Modellwahl, Plattform-Team und Compliance legen am Gateway fest, was erlaubt ist, ohne in jede Anwendung eingreifen zu müssen. Wird ein Modell gesperrt oder ein Anbieter ausgetauscht, muss keine Anwendung neu deployt werden.
In regulierten Umgebungen ist der Ort der Verarbeitung ein hartes Ausschlusskriterium: Eine Anfrage, die in der EU bleiben muss, darf unabhängig von Preis und Latenz keinen Endpoint außerhalb erreichen. Gern übersehen wird dabei, dass Gateway und Modell jeweils eine eigene Region haben. Ein EU-Gateway vor einem Modell in us-east-1 erfüllt die Anforderung nicht. Auch Fallbacks dürfen nur innerhalb des erlaubten Pools laufen. Fällt der EU-Endpoint aus, ist ein Fehler die richtige Antwort und ein stiller Wechsel in eine andere Region die falsche. Und Datenresidenz ist noch keine Souveränität, denn ein US-Anbieter mit Rechenzentrum in Frankfurt unterliegt weiter dem CLOUD Act.
Wer in einer regulierten Umgebung mit der Modellwahl anfängt und Governance auf später verschiebt, baut sie hinterher in jede Anwendung einzeln ein, und das wird mit jeder weiteren Anwendung mühsamer.
Welches Modell: statisch, Kaskade oder gelernt
Über diese Frage wird am meisten geredet. Wir haben dafür drei Ansätze gesehen, vom einfachsten bis zum aufwendigsten.
Statisch ist besser als sein Ruf
Die unspektakulärste Variante legt pro Aufgabe fest, welches Modell sie bekommt: Zusammenfassen mit dem kleinen, Verträge prüfen mit dem großen. Das wirkt wenig ambitioniert, ist bei Backend-Pipelines aber meistens die richtige Wahl, weil du dort schon zur Designzeit die Schritte kennst und weißt, wie schwer sie sind. Ein Router, der das zur Laufzeit für jede Anfrage neu einschätzt, trifft diese Entscheidung bestenfalls genauso gut.
Wichtig ist, wo die Zuordnung steht. Ist der Modellname in zwölf Dateien hart verdrahtet, wird jeder Modellwechsel zum kleinen Projekt. Ein Alias pro Aufgabe (extraction, summary, review), der an genau einer Stelle aufgelöst wird, ist in einer Stunde eingebaut und macht den nächsten Modellwechsel zu einer Konfigurationsänderung.
Kaskaden: eskalieren, wenn das Ergebnis nicht reicht
Eine Kaskade versucht es zuerst günstig und eskaliert, wenn das Ergebnis nicht genügt. In der Messe-Plattform machen wir das eine Ebene höher, mit Agents statt einzelnen Modellen: Der Primär-Agent erfasst das Quellmaterial in einem Durchgang und arbeitet unter einem festen Budget pro Lauf. Fehlen danach Pflichtfelder, übernimmt ein Fallback-Agent, der iterativ und gezielt nachsucht. Dadurch sind heute auch die rund 20 % der Messen abgedeckt, die sich vorher gar nicht verarbeiten ließen.
Das funktioniert, weil die Eskalationsbedingung hart ist: Entweder sind alle Pflichtfelder im Schema gefüllt oder nicht. Viele Kaskaden scheitern genau an dieser Stelle. Wenn du das Modell fragst, ob es sich seiner Antwort sicher ist, bekommst du zwar eine Antwort, aber kein verlässliches Signal. Ohne prüfbare Bedingung wie Schema-Validierung, Tests oder Pflichtfelder würden wir keine Kaskade bauen.
Außerdem braucht die Kette ein Ende. Bei uns sind es bewusst zwei Glieder und eine Obergrenze an Iterationen. Eine Kaskade ohne Abbruchbedingung ist eine Endlosschleife mit Rechnung.
Gelernte Router: beeindruckende Zahlen, schwer übertragbar
Gelernte Router schätzen pro Anfrage, ob ein kleines Modell reicht. Die einfachere Spielart ist ein kleiner Klassifikator, der Domäne oder Intent erkennt und über eine Policy das Modell wählt, so wie es der vLLM Semantic Router macht. Die anspruchsvollere sagt pro Anfrage voraus, wie gut jeder Kandidat antworten würde. Der bekannteste offene Ansatz dafür ist RouteLLM von LMSYS: Das Team berichtet auf MT Bench von über 85 % Kostenersparnis bei 95 % der GPT-4-Qualität, auf MMLU von 45 % und auf GSM8K von 35 %. AWS bietet mit Bedrock Intelligent Prompt Routing einen verwalteten Router, der innerhalb einer Modellfamilie wählt, und nennt bis zu 30 % Ersparnis.
Diese Zahlen lassen sich aus zwei Gründen schlecht auf ein eigenes Projekt übertragen. Erstens wird gegen „immer das größte Modell“ gemessen. Wer seine Modelle schon statisch pro Aufgabe zuordnet, startet von einer anderen Basis, und die Ersparnis schrumpft entsprechend. Zweitens schwanken die Werte stark mit dem Datensatz: Zwischen 85 % und 35 % liegt bei RouteLLM nur ein anderer Benchmark. Was ein Router bei deinen Anfragen bringt, zeigt erst eine Messung mit deinen Anfragen, und das dafür nötige Evaluationsset haben die wenigsten Teams.
Unabhängige Vergleiche fallen nüchterner aus als die Herstellerangaben. LLMRouterBench hat Anfang 2026 zehn Routing-Verfahren auf über 400.000 Instanzen mit 33 Modellen verglichen. Mehrere davon, darunter ein kommerzieller Router, schlugen das beste Einzelmodell nicht zuverlässig und senkten die Kosten nicht ohne Qualitätsverlust.
Dazu kommt ein Nachteil, der in keinem Benchmark auftaucht: Dieselbe Frage wird heute vom kleinen und morgen vom großen Modell beantwortet. In einem Chat stört das niemanden. In einer Pipeline, deren Ergebnisse jemand nachvollziehen muss, ist es bei jeder Fehlersuche eine zusätzliche Variable.
Wir setzen gelernte Router bisher nicht produktiv ein. Sinnvoll finden wir sie dort, wo die Eingaben offen sind und das Volumen groß genug ist, dass sich das Evaluieren lohnt, also bei Chat-Assistenten, im Support oder in der internen Suche.
Der Cache macht Modellwechsel teuer
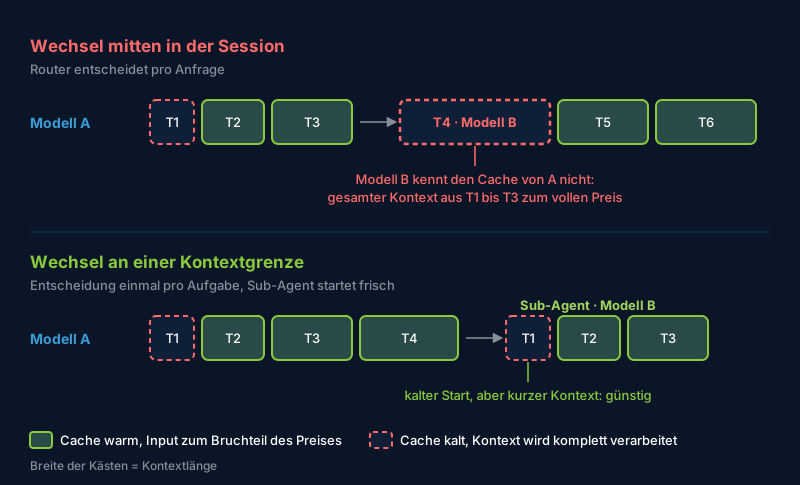
Kaskaden und gelernte Router haben einen Gegenspieler, der in vielen Router-Vergleichen fehlt: den Prompt-Cache. Er gilt nur für das Modell, das ihn geschrieben hat. Bei Anthropic kostet gecachter Input ein Zehntel des normalen Preises, das Schreiben des Caches das 1,25-Fache. Wechselt ein Router mitten in einer langen Agent-Session das Modell, wird der gesamte bisherige Kontext zum vollen Preis neu verarbeitet, und das kann die Ersparnis durch das günstigere Modell übersteigen. Je länger die Session schon läuft, desto teurer wird der Wechsel.
Ganz so einseitig ist das Bild allerdings nicht. LiteLLM hat auf eigenem Gateway-Traffic gemessen, dass der Cache des vorherigen Modells bei 97,4 % von 4.684 Rückwechseln noch warm war, und kam mit Router plus Caching günstiger weg als mit Caching auf einem festen Modell. Dieselbe Messung zeigt, was ohne Caching passiert: Ein Router mit abgeschaltetem Cache kostete etwa das Vierfache. Das sind Herstellerzahlen, aber sie zeigen, dass Routing und Caching zusammen geplant werden müssen.
Für uns folgt daraus: einmal pro Aufgabe oder Session entscheiden und dann beim Modell bleiben. Ein Wechsel passt an Stellen, an denen der Kontext ohnehin neu beginnt, etwa beim Start eines Sub-Agents oder nach einer Zusammenfassung des bisherigen Verlaufs.
In Agent-Systemen wandert die Entscheidung deshalb zunehmend in den Harness, also in den Orchestrator, der die Schritte und Sub-Agents steuert. Er ist die einzige Stelle, die weiß, wie lang der Kontext schon ist, ob der Cache warm ist und welcher Schritt ansteht: ein Review, eine Websuche, ein Refactoring. Ein Gateway sieht nur den einzelnen Request. Factory argumentiert genau so und berichtet 58 % weniger Kosten gegenüber „immer das Frontier-Modell“, wieder eine Herstellerzahl. Interessant finden wir daran etwas anderes: Die Modellwahl pro Schritt ist im Harness meist wieder eine statische Zuordnung nach Aufgabentyp, nur eben an der Stelle, die den Cache kennt.
Oft musst du das Modell auch gar nicht wechseln. ChatGPT routet seit GPT-5 zwischen schneller Antwort und längerem Nachdenken, und bei vielen aktuellen Modellen stellst du den Denkaufwand per API-Parameter ein. Wofür früher zwei Modelle und ein Router nötig waren, genügt heute oft ein Modell mit zwei Einstellungen. Wie sich eine geänderte Einstellung auf den Cache auswirkt, unterscheidet sich je Anbieter und gehört vorher geprüft.
Welcher Anbieter: was wir umgestellt haben
Viele Modelle bekommst du bei mehreren Anbietern: direkt beim Hersteller, über die großen Clouds, über Inference-Dienste und Aggregatoren. Die Gewichte sind dieselben, Preise und Kapazität unterscheiden sich.
In der Messe-Plattform haben wir anfangs nach Preis geroutet. Das lag nahe, denn die Pipeline läuft im Hintergrund und niemand wartet auf eine Antwort. In der Praxis landeten wir damit regelmäßig bei einem Anbieter, der gerade eine Preisaktion fuhr. Solche Aktionen ziehen Last an, und genau in diesen Phasen war der Anbieter überlastet. Der günstigste Anbieter war also ausgerechnet dann am unzuverlässigsten, wenn das Routing ihn bevorzugte. Anfragen liefen in Timeouts und Rate Limits, Läufe mussten wiederholt werden, und Messen blieben länger unvollständig, als uns lieb war.
Heute routen wir nach Zuverlässigkeit und Durchsatz. Der Preisunterschied pro Lauf ist kleiner als die Kosten eines fehlgeschlagenen Laufs: die Wiederholung, die Verzögerung, bis die Daten aktuell sind, und das Rauschen im Monitoring, in dem echte Fehler untergehen. Im Nachhinein hätten wir das von Anfang an so einstellen sollen.
Schwierig ist die Umstellung nicht. Gateways, Aggregatoren und Client-Bibliotheken bringen die nötigen Schalter mit: Sortierung nach Preis, Durchsatz oder Latenz, Fallback-Listen, Cooldowns für Endpoints, die gerade Fehler liefern. Das Problem ist der Default. Er steht häufig auf Preis oder wird beim Einrichten so gesetzt, weil es naheliegt, und danach schaut ihn niemand mehr an, bis der erste Tag mit Lastspitzen kommt.
Bei Fallbacks zwischen Anbietern gilt eine Einschränkung: Harmlos sind sie nur, wenn wirklich dasselbe Modell antwortet. Weicht der Fallback auf ein „ähnliches“ Modell eines anderen Herstellers aus, ändert sich das Verhalten deiner Anwendung. Das ist dann eine Modellwahl und braucht eine eigene Evaluation. Selbst beim gleichen Modell unterscheiden sich Anbieter manchmal in Details wie maximaler Kontextlänge oder Quantisierung, was du einmal prüfen solltest, bevor ein Anbieter auf die Fallback-Liste kommt. In regulierten Umgebungen kommt die Regel von oben dazu: Auf die Liste gehören nur Anbieter und Regionen aus dem erlaubten Pool.
Wo wir anfangen würden
Wenn uns heute jemand fragt, womit er bei Model Routing anfangen soll, empfehlen wir diese Reihenfolge. Sie richtet sich danach, was im Betrieb am meisten bringt, und weicht deshalb von der Nummerierung oben ab.
- Erst messen. Sammle Traces mit Modell, Kosten, Cache-Trefferquote und Erfolg der Aufgabe. Ohne diese Basis kannst du später nicht beurteilen, ob ein Router etwas bringt.
- Governance früh, wenn du in einer regulierten Umgebung arbeitest oder mehrere Teams LLMs nutzen. Ein Gateway lässt sich am Anfang leicht einziehen, später musst du dafür jede Anwendung einzeln anfassen.
- Anbieter-Routing als Nächstes, mit Fallbacks und einem Default nach Zuverlässigkeit. Das bringt in Produktion mehr als jeder Klassifikator.
- Modellwahl statisch pro Aufgabe, mit Aliasen, die an einer Stelle konfiguriert sind.
- Kaskaden nur dort, wo sich das Ergebnis prüfen lässt, und immer mit fester Obergrenze.
- Gelernte Router erst, wenn Evaluationsset und Volumen vorhanden sind. Miss sie dann gegen deine statische Zuordnung mit warmem Cache und nicht gegen „immer das größte Modell“. Ein fester Satz Prompts mit erwarteter Zuordnung gehört in die CI, weil verwaltete Router ihren Modellpool ändern, ohne dass du etwas deployst.
Für unsere eigenen Projekte haben wir daraus zwei Dinge übernommen: Anbieter wählen wir standardmäßig nach Zuverlässigkeit statt nach Preis, und Modellnamen stehen in der Konfiguration statt im Code. Für alles Weitere hilft eine einfache Übung: Schreib auf, welche der drei Fragen dein Router beantworten soll, bevor du dich für einen entscheidest. Lautet die Antwort „alle“, prüf, welche davon dein Werkzeug wirklich beantwortet und welche nur nebenbei. Ein Gateway bringt Governance und Fallbacks mit, ein Cloud-Anbieter einen gelernten Router für seinen eigenen Katalog. Drei Produkte brauchst du dafür nicht unbedingt, aber drei Entscheidungen, die getrennt konfiguriert und getrennt geprüft werden.